Architektur der Spider
Voraussetzungen
- Sie haben die Seite Fetcher-Grundlagen gelesen und wissen, welche Fetcher es gibt und wann Sie diese verwenden.
- Sie haben die Seite Hauptklassen gelesen und kennen die Klassen Selector und Response.
Scraplings Spider-System ist ein von Scrapy inspiriertes Framework für asynchrone Crawls. Es unterstützt parallele Anfragen, mehrere Sitzungen sowie das Pausieren und Fortsetzen. Es verbindet Scraplings Parser und Fetcher in einer gemeinsamen Crawl-API und ergänzt die Planung von Anfragen, die Steuerung paralleler Abläufe und Checkpoints.
Wenn Sie Scrapy kennen, finden Sie sich schnell zurecht. Falls nicht, ist das kein Problem. Das System ist einfach aufgebaut.
Datenfluss
Das Diagramm zeigt, wie Daten während eines Crawls durch das Spider-System fließen:
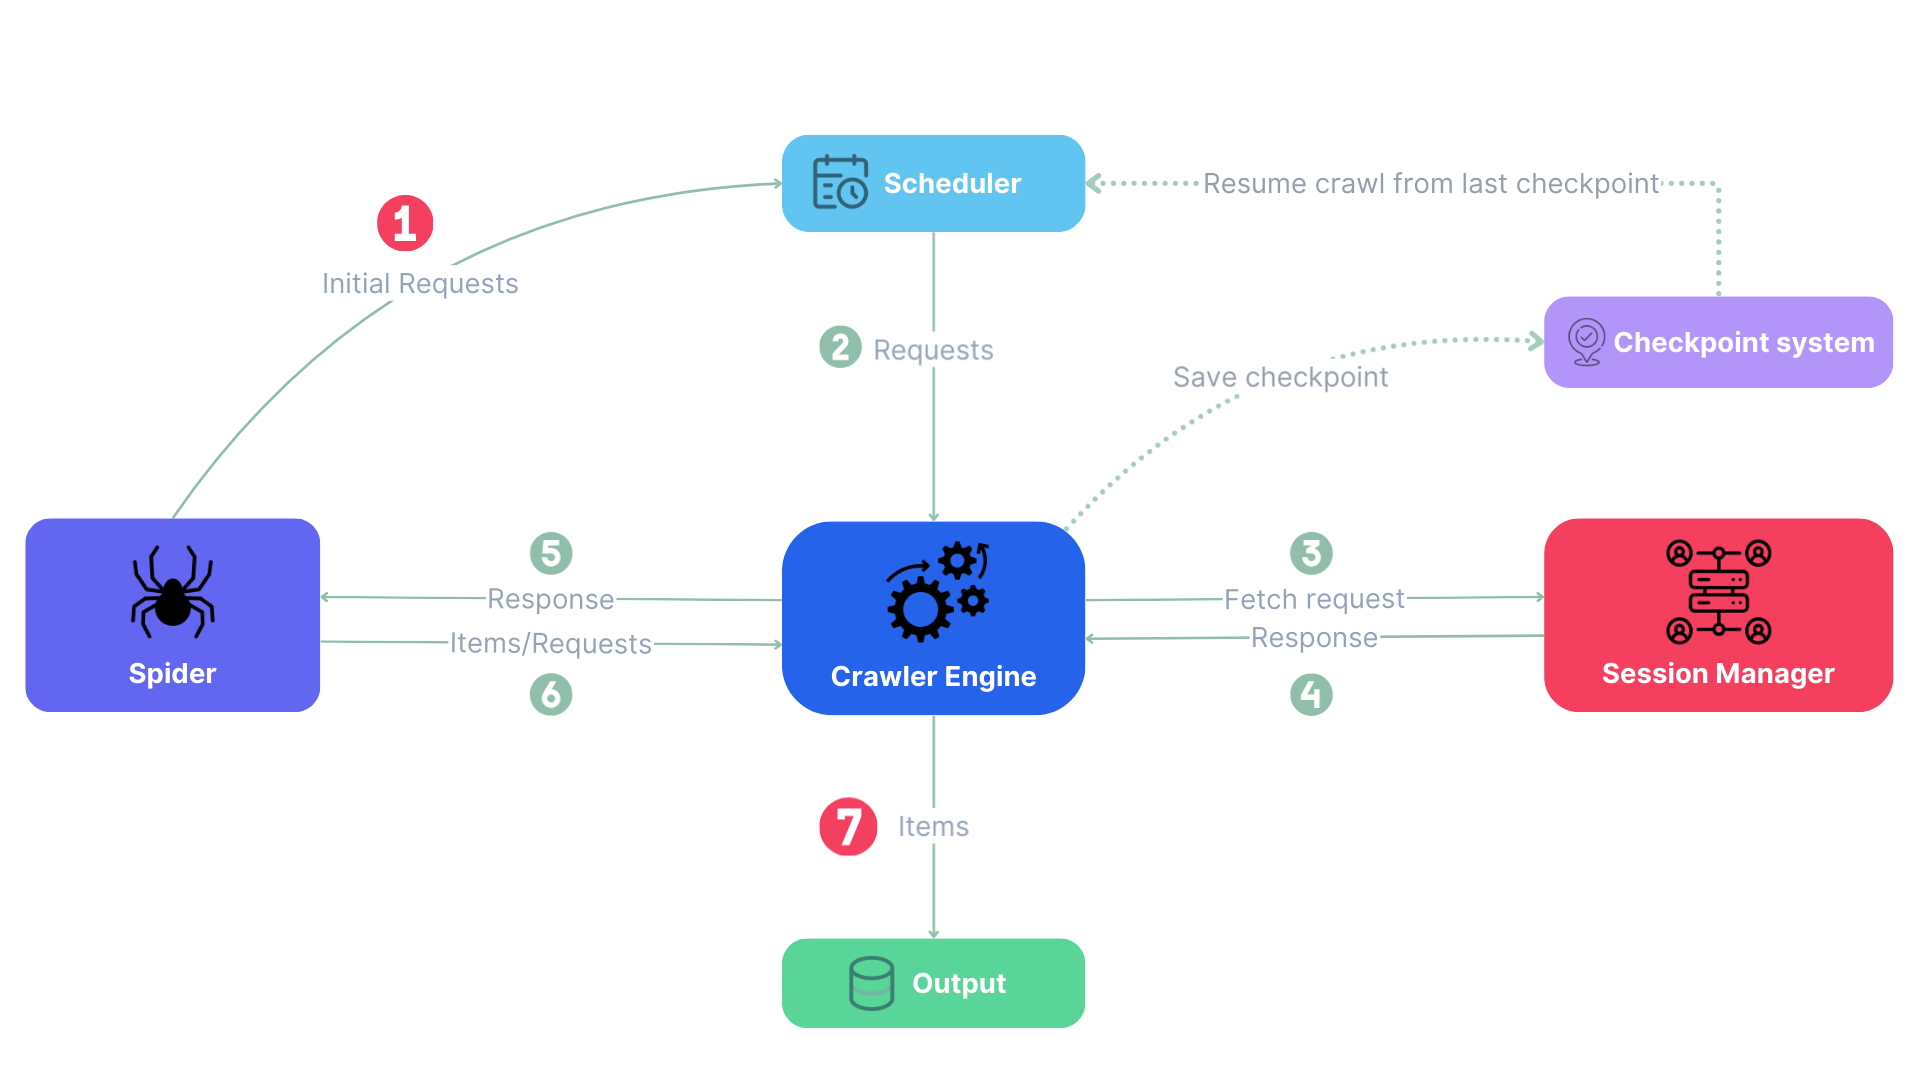
Beim Start eines Spiders läuft vereinfacht Folgendes ab:
- Der Spider erzeugt die ersten
Request-Objekte. Standardmäßig erstellt er eine Anfrage für jede URL instart_urls. Für eigene Abläufe können Siestart_requests()überschreiben. - Der Scheduler nimmt die Anfragen entgegen, legt sie in eine Prioritätswarteschlange und erstellt ihre Fingerprints. Anfragen mit höherer Priorität werden zuerst entnommen.
- Die Crawler-Engine fordert die nächste Anfrage beim Scheduler an. Dabei beachtet sie die globalen und domainspezifischen Grenzen für parallele Anfragen sowie die Wartezeiten. Wenn
robots_txt_obeyaktiv ist, prüft sie zuerst die robots.txt-Regeln der Domain. Nicht erlaubte Anfragen werden ohne Meldung verworfen. Die Crawler-Engine gibt die Anfrage dann an den Session Manager weiter. Dieser wählt anhand vonsid(Sitzungs-ID) die passende Sitzung. - Die Sitzung ruft die Seite ab und gibt ein Response-Objekt an die Crawler-Engine zurück. Die Engine erfasst Statistiken und prüft, ob die Antwort auf eine Sperre hinweist. Bei einer Sperre versucht sie die Anfrage bis zu
max_blocked_retriesMal erneut. Sie können sowohl die Erkennung als auch die Wiederholungslogik anpassen. - Die Crawler-Engine übergibt die Response an den Callback der Anfrage. Der Callback liefert entweder ein Dictionary, das als extrahierter Datensatz behandelt wird, oder eine Folgeanfrage, die der Scheduler in die Warteschlange aufnimmt.
- Der Ablauf wiederholt sich ab Schritt 2, bis der Scheduler leer ist und keine Aufgaben mehr laufen oder der Spider pausiert wird.
- Wenn beim Start des Spiders
crawldirgesetzt ist, speichert die Crawler-Engine regelmäßig einen Checkpoint auf der Festplatte. Er enthält offene Anfragen und bereits besuchte URLs. Beim geordneten Beenden mit Strg+C wird ein letzter Checkpoint gespeichert. Beim nächsten Start mit demselbencrawldirsetzt der Spider dort fort. Er überspringtstart_requests()und stellt den Zustand des Schedulers wieder her.
Komponenten
Spider
Die zentrale Klasse, mit der Sie arbeiten. Sie erstellen eine Unterklasse von Spider und legen start_urls sowie die Methode parse() fest. Bei Bedarf konfigurieren Sie Sitzungen und überschreiben Lebenszyklus-Hooks.
from scrapling.spiders import Spider, Response, Request

class MySpider(Spider):
    name = "my_spider"
    start_urls = ["https://example.com"]

    async def parse(self, response: Response):
        for link in response.css("a::attr(href)").getall():
            yield response.follow(link, callback=self.parse_page)

    async def parse_page(self, response: Response):
        yield {"title": response.css("h1::text").get("")}
Crawler-Engine
Die Engine steuert den gesamten Crawl. Sie verwaltet die Hauptschleife, begrenzt parallele Anfragen, sendet Anfragen über den Session Manager und verarbeitet die Ergebnisse der Callbacks. Sie müssen sie nicht direkt aufrufen. Das übernehmen Spider.start() und Spider.stream() für Sie.
Scheduler
Eine Prioritätswarteschlange, die doppelte URLs automatisch erkennt. Die Fingerprints der Anfragen basieren auf URL, HTTP-Methode, Body und Sitzungs-ID. Mit snapshot() und restore() unterstützt der Scheduler das Checkpoint-System. So kann der Zustand des Crawls gespeichert und später wiederhergestellt werden.
Session Manager
Verwaltet eine oder mehrere benannte Sitzungen. Jede Sitzung hat einen dieser Typen:
Der Session Manager leitet eingehende Anfragen anhand des Feldes sid an die richtige Sitzung weiter. Sitzungen starten entweder zusammen mit dem Spider (Standard) oder erst bei ihrer ersten Verwendung.
Checkpoint-System
Ein optionales System, das den Zustand des Crawlers als pickle-Datei auf der Festplatte speichert. Dieser Zustand umfasst offene Anfragen und Fingerprints bereits besuchter URLs. Schreibvorgänge sind atomar (temporäre Datei und Umbenennen), damit Dateien nicht beschädigt werden. Checkpoints werden in einem einstellbaren Abstand und beim geordneten Beenden gespeichert. Nach einem erfolgreich abgeschlossenen Crawl, der nicht pausiert wurde, werden die Checkpoint-Dateien automatisch entfernt.
Antwort-Cache
Ein optionaler Cache, der im Entwicklungsmodus alle abgerufenen Antworten auf der Festplatte speichert und bei späteren Läufen wiederverwendet. Jede Antwort wird über den Fingerprint der Anfrage zugeordnet und als JSON gespeichert. Der Body wird mit Base64 kodiert, damit Binärdaten erhalten bleiben. Der Cache dient zum Überarbeiten der parse()-Logik, ohne die Zielserver erneut aufzurufen. Er ist nicht für den Produktivbetrieb gedacht.
Ausgabe
Die extrahierten Datensätze werden in einer ItemList gesammelt. Diese Unterklasse von list bietet die Exportmethoden to_json(), to_jsonl(), to_csv() und to_xml(). Die Dataclass CrawlStats erfasst die Crawl-Statistiken und enthält viele nützliche Angaben.
Vergleich mit Scrapy
Wenn Sie von Scrapy kommen, hilft Ihnen diese Zuordnung:
| Konzept | Scrapy | Scrapling |
|---|---|---|
| Spider definieren | Unterklasse von scrapy.Spider |
Unterklasse von scrapling.spiders.Spider |
| Erste Anfragen | start_requests() |
async start_requests() |
| Callbacks | def parse(self, response) |
async def parse(self, response) |
| Links folgen | response.follow(url) |
response.follow(url) |
| Datensätze ausgeben | yield dict oder yield Item |
yield dict |
| Anfragen planen | Scheduler + Dupefilter | Scheduler mit eingebauter Erkennung doppelter Anfragen |
| Herunterladen | Downloader + Middlewares | Session Manager mit Unterstützung für mehrere Sitzungen |
| Datensätze verarbeiten | Item Pipelines | Hook on_scraped_item() |
| Sperren erkennen | Eigene Middlewares | Eingebaute Hooks is_blocked() + retry_blocked_request() |
| Parallele Anfragen | Einstellung CONCURRENT_REQUESTS |
Klassenattribut concurrent_requests |
| Domains filtern | allowed_domains |
allowed_domains |
| robots.txt | Einstellung ROBOTSTXT_OBEY |
Klassenattribut robots_txt_obey |
| Pausieren/Fortsetzen | Einstellung JOBDIR |
Konstruktorargument crawldir |
| Exportieren | Feed-Exporte | result.items.to_json() / to_jsonl() / to_csv() / to_xml() oder eigene Exporte über Hooks |
| Starten | scrapy crawl spider_name |
MySpider().start() |
| Streaming | Nicht verfügbar | async for item in spider.stream() |
| Mehrere Sitzungen | Nicht verfügbar | Mehrere Sitzungen verschiedener Typen pro Spider |